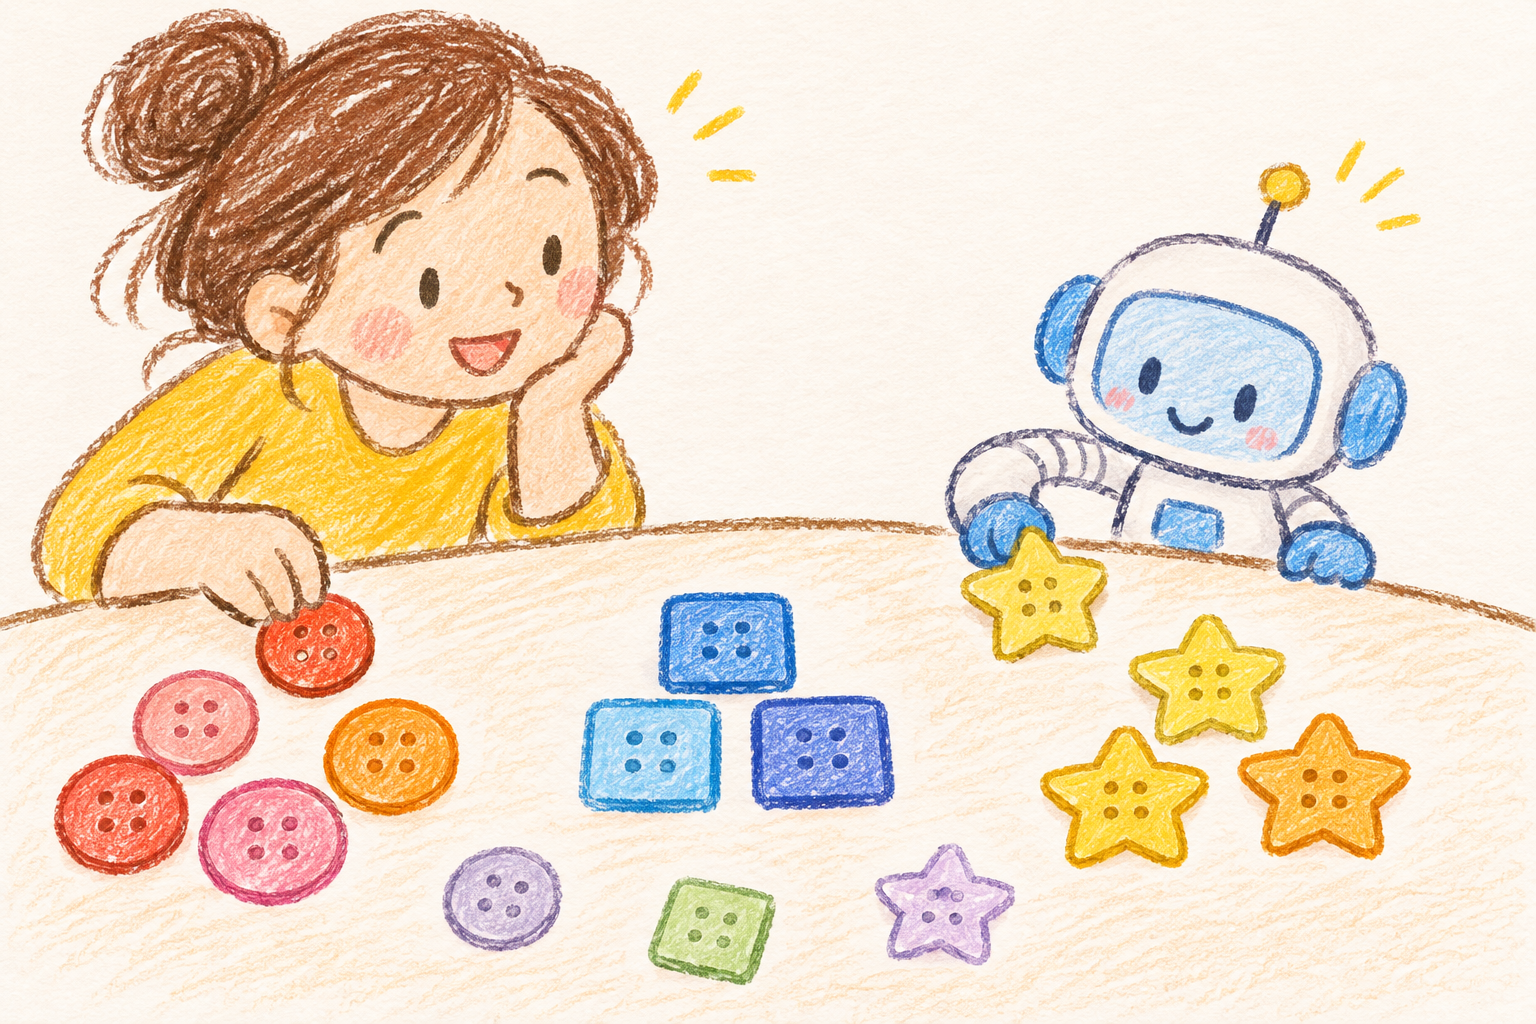
단추가 한 상자에 섞여 있다고 상상해 봐요. 미리 정해 둔 이름표 없이 비슷한 단추끼리 모으면 어떤 묶음이 생길까요? 이런 생각과 연결되는 AI 기술이 군집화입니다.
정답 이름표 없이 묶음을 찾아요
군집화는 자료 사이의 비슷한 정도를 바탕으로 묶음을 만드는 방법입니다. 각 자료에 ‘정답 범주’를 미리 붙여 학습시키지 않는 비지도 학습의 한 종류입니다. Google의 군집화 설명도 이름표가 없는 자료의 유사성을 기준으로 설명합니다.
앞서 배운 분류는 미리 정한 범주를 예측하는 일이었습니다. 군집화에서는 비슷한 자료의 묶음을 찾고, 그 묶음에 어떤 의미가 있는지 살펴봅니다. 묶음에 나중에 이름을 붙일 수는 있지만, 그 이름이 처음부터 주어진 정답은 아닙니다.
무엇을 비슷하다고 볼까요?
단추를 색깔 중심으로 모으면 같은 색끼리, 크기 중심으로 모으면 비슷한 크기끼리 모일 수 있겠죠. 이것은 원리를 설명하는 가상 비유이며 실제 AI의 계산 결과가 아닙니다.
AI가 자료를 비교할 때 쓰는 색·크기 같은 정보를 특성이라고 합니다. 어떤 특성을 사용하고 비슷한 정도를 어떻게 계산하느냐에 따라 묶음이 달라질 수 있습니다.
숫자의 크기도 살펴봐야 해요
여러 특성을 숫자로 비교한다면 단위와 값의 범위도 중요합니다. 같은 단추의 지름도 센티미터로 쓸 때와 밀리미터로 쓸 때 숫자가 달라집니다. 이런 차이가 비교에 어떤 영향을 주는지 확인해야 해요.
Google의 자료 준비 안내는 특성들의 척도를 맞추기 전후에 자료의 유사성이 다르게 계산될 수 있음을 보여 줍니다. 초보자는 계산법보다 “무슨 정보를 어떤 기준으로 비교했나요?”라는 질문을 기억하면 충분합니다.
묶음은 살펴볼 단서예요
예를 들어 많은 검색 결과를 비슷한 내용끼리 묶으면 자료를 둘러보는 데 활용할 수 있습니다. 하지만 묶음이 나왔다는 사실만으로 세상에 꼭 그 종류만 존재한다고 결론 내릴 수는 없습니다.
군집화 결과를 볼 때는 각 묶음에 어떤 자료가 들어갔는지 직접 살펴보세요. 비슷하게 묶였다는 이유만으로 같은 원인이나 같은 가치를 지녔다고 단정하지 않는 것이 좋습니다.
오늘의 핵심은 군집화는 미리 붙인 정답 이름표 대신, 정한 비교 기준으로 비슷한 자료의 묶음을 찾는 방법이라는 점입니다.
출처와 확인일
- Google Machine Learning — What is clustering?: 군집화의 정의, 분류와의 구분, 유사성 기준과 활용 예.
- Google Machine Learning — Data preparation: 특성의 척도와 유사성 계산.
두 문서 수정일: 2025년 8월 25일. 자료 확인일: 2026년 11월 2일 미국 태평양 시간. 단추 예시는 설명용 비유이며 특정 모델을 시험한 결과가 아닙니다.
답글 남기기