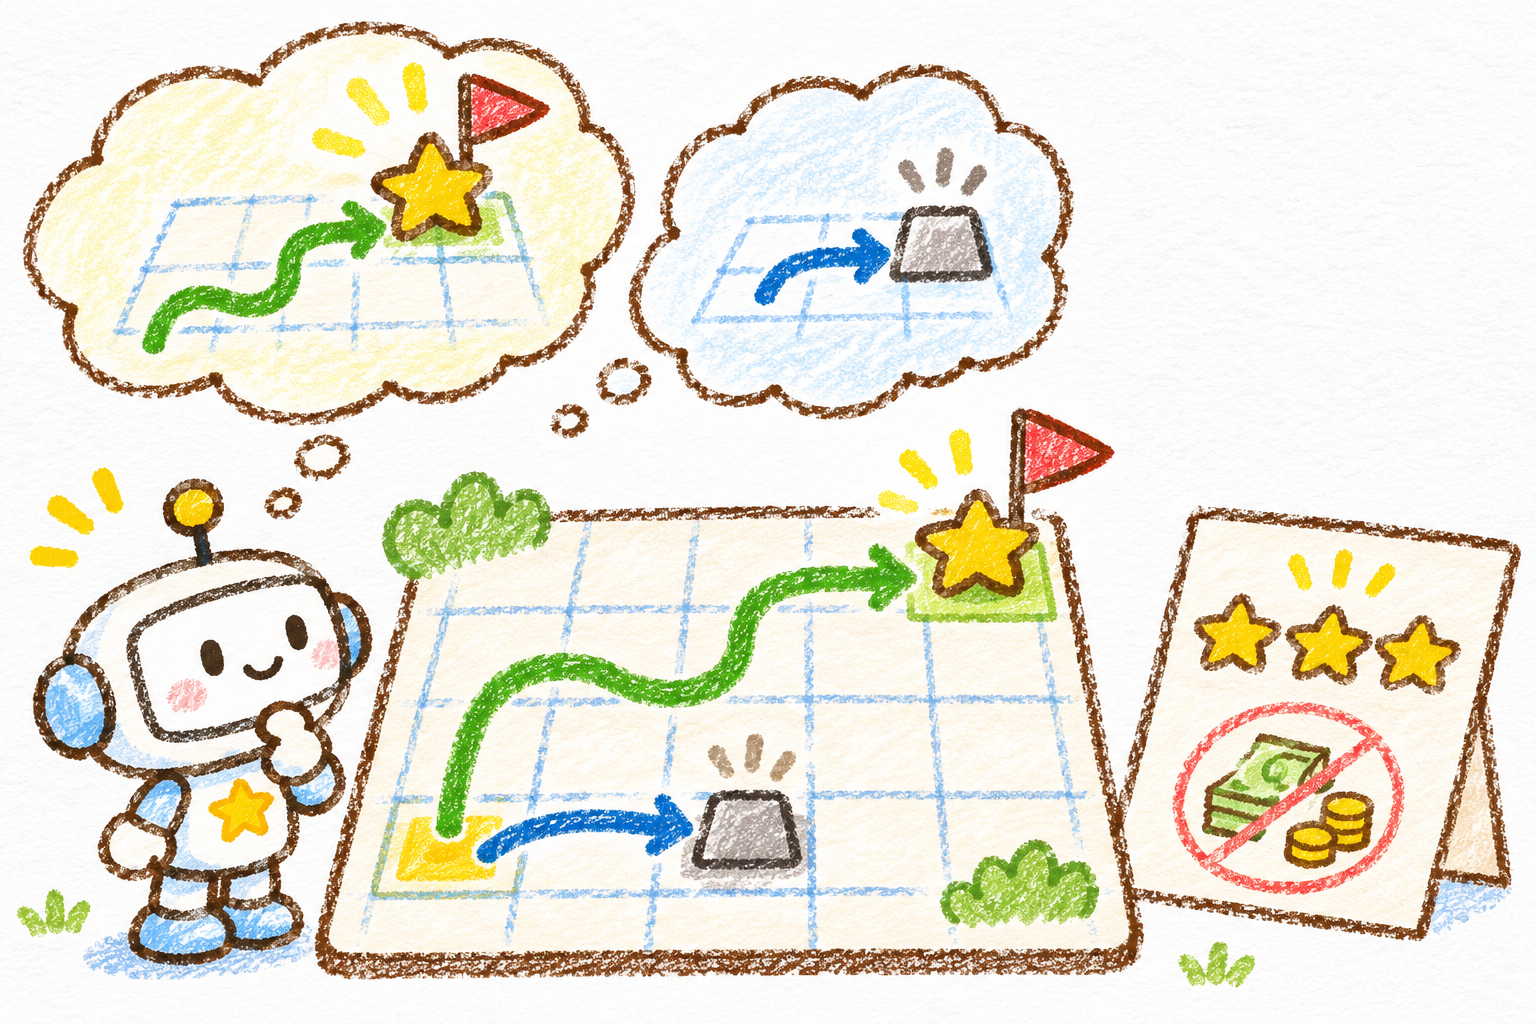
AI가 어떤 행동을 한 뒤 그 결과를 점수로 받아 배울 수도 있을까요? 강화학습은 주변 상황을 보고 행동을 고른 다음, 결과로 받은 보상을 바탕으로 행동 선택 방법을 학습하는 방식입니다. 여기서 보상은 학습에 쓰는 숫자 신호를 뜻합니다.
행동과 결과를 연결해요
강화학습에서는 학습하는 AI와 행동이 이루어지는 환경이 서로 영향을 주고받습니다. AI는 행동을 선택한 뒤, 그 결과에 따른 상황과 보상을 확인합니다. 이런 경험을 활용해 다음에 어떤 행동을 선택할지 정하는 방법을 조정합니다. OpenAI의 강화학습 기초 설명
길 찾기 게임으로 생각해 봐요
다음은 원리를 설명하는 가상의 예시입니다. 작은 로봇이 격자판에서 위·아래·왼쪽·오른쪽으로 움직이는 게임을 떠올려 보세요. 목적지에 닿으면 +10점과 함께 게임이 끝나고, 벽에 부딪히면 -1점, 그 밖의 이동은 0점이라고 정합니다.
로봇은 여러 시도에서 얻은 경험을 학습에 활용합니다. 이때 +10점은 로봇이 기쁨을 느낀다는 뜻이 아닙니다. 어떤 결과에 얼마의 점수를 주도록 설계했는지를 나타내는 값입니다.
지금 점수와 나중 점수를 함께 봐요
강화학습의 목표는 당장 가장 높은 점수를 받는 행동만 고르는 것이 아닙니다. 앞으로 받을 보상을 합친 값이 평균적으로 커지도록 행동 선택 방법을 배우는 것입니다. 이를 누적 보상을 높인다고 설명합니다.
가상의 게임에서도 지금 이동한 칸의 점수가 0점이어도, 그 길을 따라 목적지에 도착하면 나중에 +10점을 얻을 수 있습니다. 행동을 여러 번 이어 간 결과까지 고려하는 것이죠. 다만 시도할 때마다 반드시 실력이 나아지거나 최선의 경로를 찾는다고 보장되지는 않습니다. 보상과 누적 보상의 차이
점수 기준도 잘 정해야 해요
점수를 잘 받는 행동이 사람이 바라던 결과와 어긋날 수도 있습니다. OpenAI의 보상 설계 설명은 복잡한 목표를 단순한 점수로 대신할 때 원치 않는 행동이 나올 수 있다고 짚습니다. 그래서 학습 결과를 볼 때는 점수뿐 아니라 실제 목표를 달성했는지도 확인해야 합니다.
오늘 기억할 것은 강화학습은 행동의 결과를 숫자 보상으로 받아, 더 나은 행동 선택 방법을 배우는 과정이라는 점입니다.
출처와 확인일
- OpenAI Spinning Up — Part 1: Key Concepts in RL: 행동, 환경, 수치 보상과 누적 보상의 정의. 게시·수정일 표시 없음.
- OpenAI — Learning from human preferences: 목표와 보상 기준이 어긋날 수 있다는 설명. 2017년 6월 13일 게시.
공식 자료 확인: 2026년 11월 3일(미국 태평양 시간). 격자판 게임은 설명용 가상 예시이며 실제 모델을 시험한 결과가 아닙니다.
이 글과 그림은 AI의 도움을 받아 작성했습니다. 중요한 정보는 원문과 공식 자료에서 다시 확인해 주세요.
답글 남기기